Data drift - co robić gdy model traci formę?
21 kwietnia 2023
Ostatnia aktualizacja 5 sierpnia 2024
Autor tekstu eksperckiego: Paweł Sobel, Data Scientist
Jednym z pierwszych data scientistów, który zwrócił uwagę na problem dryfu danych (ang. data drift) był żyjący około 2500 lat temu Heraklit z Efezu. Dostrzegł on, że zmiana jest jedynym stałym składnikiem rzeczywistości. Jednak jak to filozoficzno-humorystyczne odniesienie ma się do danych i uczenia maszynowego? Kto choć raz zbudował model, a następnie wykorzystywał go w dłuższym okresie zapewne już dobrze wie o co chodzi. Niemal każdy model z czasem traci na aktualności, a co za tym idzie obniża swoje zdolności predykcyjne. Dryf danych jest zatem zjawiskiem powodującym obniżenie skuteczności modeli w czasie.
Kilka przykładów modeli dziedzinowych oraz zmian, które wpływają na pogorszenie jakości prognoz najlepiej zobrazuje problem dryfu:
- model scoringu kredytowego lub cen akcji na giełdzie – zjawiska nieprzewidywalne, wpływające negatywnie na rentowność całej ekonomii, niedawna pandemia oraz wojna w Ukrainie oraz jej gospodarcze skutki są tego przykładem,
- model zakupowy klienta – ciąża i narodziny dziecka powodują zmiany koszyka zakupowego rodziny, dochodzą nowo kupowane produkty jak pieluchy czy chusteczki, zmieniają się produkty chemiczne stosowane do prania, czasem zauważalna jest zmiana nawyków żywieniowych – wybierane są produkty zdrowsze, niezawierające laktozy, pojawia się piwo bezalkoholowe,
- model fraudowy – nowy, nieznany wcześniej sposób dokonywania oszustw, przykładowo dotychczas oszuści przejmowali sesję klienta od samego zalogowania, a teraz przejmują ją w trakcie jej trwania za pomocą udostępnienia kontroli przez zdalny pulpit instalowany na komputerze ofiary.
Taksonomia
Biorąc po uwagę różne rodzaje dryfu wyróżnia się:
- dryf cech – zmiany w rozkładach poszczególnych zmiennych niezależnych przy jednoczesnym zachowaniu rozkładu zmiennej celu, przykładowo zmiana miesięcznych dochodów restauracji w okresie lockdownu w modelu przewidującym kondycję gospodarki,
- dryf zmiennej celu / dryf etykiet – zmiana w rozkładzie etykiet przy jednoczesnym braku zmian cech niezależnych, przykładowo wzrost procentowej liczby oszustw z 1% do 3% wszystkich występujących zdarzeń,
- dryf koncepcji – zmiana relacji zachodzących między zmiennymi niezależnymi i zmienną celu, przykładowo zmiana weryfikacji zachowań użytkowników bankowości elektronicznej wywołana np. zmianą klawiatury lub złamaniem ręki.
W przypadku modeli weryfikacyjnych najczęściej mamy do czynienia z ostatnim typem dryfu. W zależności od charakterystyki i tempa zmian koncepcji wyróżniamy:
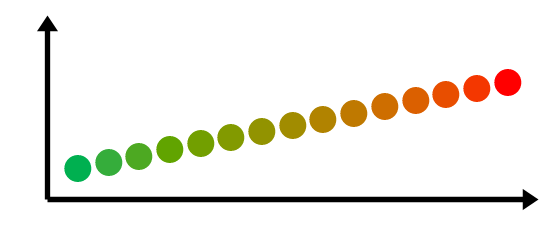
- dryf przyrostowy – cechy ulegają powolnej zmianie,
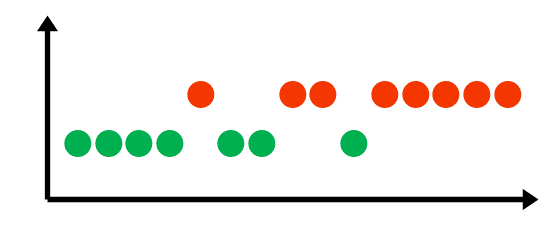
- dryf stopniowy - różne charakterystyki występują naprzemiennie, z czasem nowe wzorce zastępują stare,
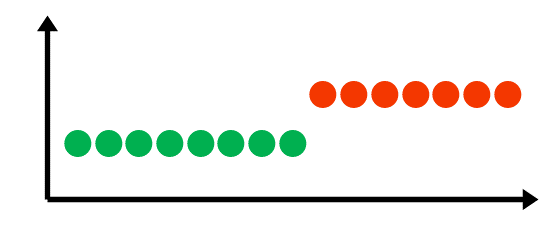
- dryf nagły - nowe charakterystyki nagle zastępują stare,
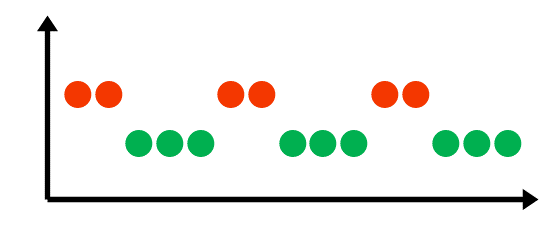
- dryf powtarzający się / powracający - wzorce zachowań występują cyklicznie, może to wynikać natury danych lub sezonowości,
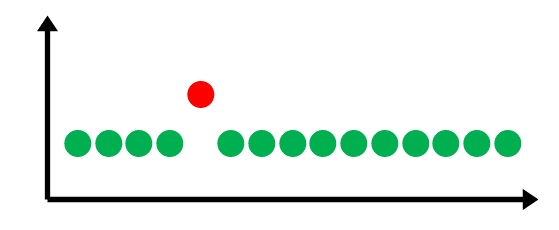
- dryf jednorazowy - jednorazowe pojawienie się nowego wzorca traktowane jako wartość odstająca.
Wykrywanie dryfu koncepcji
Wiedząc czym dryf jest i jakie są jego rodzaje warto zastanowić się w jaki sposób go wykrywać. Podejście eksperckie bazujące na znajomości swojej dziedziny lub biznesu polegać będzie na reagowaniu na występujące zmiany. Reorganizacja przestrzeni sprzedażowej w sklepie będzie miała duży wpływ na zmianę reguł zakupowych klientów. Wprowadzenie nowej wersji strony internetowej zmieni user experience, a tym samym wpłynie na zachowania użytkowników. Tego typu wydarzenia będą najprawdopodobniej wymagały budowy nowych modeli bazujących jedynie na najświeższych danych. Innym sposobem wykrywania dryfu są podejścia bazujące na analizie danych lub zastosowaniu uczenia maszynowego:
- statystyczna kontrola procesu (SPC) polegająca na monitorowaniu wartości zmiennych i wykrywaniu odchyleń,
- indeks stabilności populacji (PSI) porównujący stabilność rozkładu zmiennej pomiędzy populacją bazową i testową w oparciu o to jak obserwacje rozkładają się w zdefiniowanych odgórnie zakresach,
- porównanie podobieństwa / pomiar odległości pomiędzy danymi bazowymi i testowymi w oparciu o metryki takie jak: test Kolmogorova-Smirnova, dywergencja Kullbacka-Leiblera, dywergencja Jensena-Shannona, test zgodności chi-kwadrat, odległość Wassersteina i inne…,
- zastosowanie klasteryzacji na danych bazowych, a następnie predykcja klastrów dla danych testowych oraz porównanie rozkładów przypisanych klastrów,
- użycie analizy głównych składowych (PCA) i błędu rekonstrukcji do wykrycia dryfu między danymi bazowymi i testowymi,
- budowa binarnego klasyfikatora próbującego skutecznie rozpoznać pochodzenie danych (zbiór bazowy czy testowy),
- oraz wiele innych metod (do przejrzenia tu [1] lub tu [2]).
Osobom korzystającym z pythona w detekcji dryfu (i nie tylko!) pomogą następujące biblioteki:
- evidently,
- deepchecks,
- nannyml,
- alibi-detect,
- river
Radzenie sobie z dryfem
Wykrycie dryfu wiąże się z koniecznością poradzenia sobie z nim lub przynajmniej zniwelowania jego wpływu. Zrobić to można na kilka sposobów:
- aktualizacja modelu – wykrycie dryfu sugeruje występowanie nowych wzorców w danych. Aby pokryć je modelem konieczna jest jego aktualizacja. Jeśli pojawienie się nowych wzorców jest jednoznaczne z niewystępowaniem starych to najskuteczniejsze będzie wytrenowanie nowego modelu na najświeższych danych. W sytuacji gdy w przyszłości mogą występować zarówno nowe jak i stare wzorce dobrym wyborem może być również “przebudowa” modelu (ang. refitting), która pozwoli na zachowanie stabilności modelu dla starych wzorców i douczenie się nowych.
- dostrojenie punktu odcięcia (ang. cutoff threshold) – rozwiązanie szybkie, lecz dalekie od ideału. W modelu fraudowym każda obserwacja z prawdopodobieństwem równym lub wyższym zadanemu progowi odcięcia zostanie przypisana do klasy oszusta. Pod wpływem dryfu jakość modelu ulega osłabieniu i granica ta przestaje być skuteczna. Manipulacja progiem odcięcia może poprawić wykrywanie oszustów (ang. TPR – true positive rate) jednocześnie najprawdopodobniej osłabiając specyificzność modelu (ang. TNR – true negative rate). Taka zmiana niesie zatem spory koszt, a jej możliwość wprowadzenia zależy od konkretnej sytuacji.
- doważanie świeższych obserwacji – metoda polegająca na zwiększeniu istotności nowszych wzorców już na etapie obliczania funkcji straty algorytmu. W przypadku metod takich jak XGBoost czy CatBoost wektor wag obserwacji przekazać można za pomocą parametru sample_weight.
Wymienione podejścia do opanowania dryfu to zaledwie kilka bazowych rozwiązań. W rzeczywistości należy sobie również zadać pytanie jaki jest odpowiedni zakres danych, z których model każdorazowo jest budowany. Niektóre dane historyczne nie wnoszą nic wartościowego do modelu, a jedynie zwiększają złożoność obliczeniową. Stopniowe “wyłączanie” starszych sekwencji danych w oparciu o metryki dryfu może pomóc w budowie odpowiedniego systemu. Działania podjęte w celu poradzenia sobie ze zmianami wzorców będą również zależne od typu problemu, z którym się borykamy. Pracując na niezbalansowanych zbiorach danych dobrym rozwiązaniem będzie nadpróbkowanie (ang. oversampling) klasy mniej licznej ze szczególnym uwzględnieniem najświeższych danych poprzez nadanie im odpowiednio wyższych wag prawdopodobieństwa wylosowania.
Dryf danych jest ściśle związany z budową i utrzymaniem modeli uczenia maszynowego. Do jego wykrycia konieczne jest monitorowanie systemu. Zmiany w rozkładach danych lub obniżenie efektywności predykcji mogą świadczyć o wystąpieniu dryfu. Sposoby radzenia sobie z nim są uzależnione od siły zmian i charakterystyki problemu, z którym się mierzymy. Istotne jest odpowiednio częste aktualizowanie modeli i szybkość reakcji. Dryf można opanować gdy tylko pozna się jego specyfikę i odpowiednio zaprojektuje system uczenia modeli.
Źródła:
[1] J. Lu, A. Liu, F. Dong, F. Gu, J. Gama and G. Zhang, "Learning under Concept Drift: A Review," in IEEE Transactions on Knowledge and Data Engineering, vol. 31, no. 12, pp. 2346-2363, 1 Dec. 2019, doi: 10.1109/TKDE.2018.2876857.
[2] Gemaque, RN, Costa, AFJ, Giusti, R, dos Santos, EM. An overview of unsupervised drift detection methods. WIREs Data Mining Knowl Discov. 2020; 10:e1381. https://doi.org/10.1002/widm.1381
[3] https://miroslawmamczur.pl/czym-jest-i-jak-zbadac-dryft-modelu-model-drift/